C++入门详解:命名空间、函数重载、引用与C++11基础语法

C++入门详解:命名空间、函数重载、引用与C++11基础语法
LichermioneC++在C语言的基础上增加了更强的类型系统、面向对象、泛型编程以及现代标准库。对于刚从C语言过渡到C++的学习者来说,最先需要建立的不是“多记几个新语法”,而是理解这些语法解决了什么问题。
本文系统梳理C++入门阶段的十个核心知识点:关键字、命名空间、输入输出、缺省参数、函数重载、引用、内联函数、auto、范围for和nullptr,并补充常见误区、编译原理与面试问题。
一、C++与C语言的关系
C++最初是在C语言基础上发展而来的,因此保留了大量C语言语法。
C++ 是一门多范式编程语言,支持面向过程、面向对象、泛型编程、函数式编程以及模板元编程,同时也广泛支持并发和事件驱动程序设计。
例如:
- 基本数据类型;
- 分支与循环;
- 指针和数组;
- 函数;
- 结构体;
- 预处理、编译、链接模型。
与此同时,C++又加入了许多重要能力:
- 命名空间;
- 函数重载;
- 引用;
- 类与对象;
- 继承和多态;
- 模板与STL;
- 异常;
- RAII资源管理;
- Lambda表达式;
- 移动语义和智能指针。
因此,C++并不是“带类的C”这么简单。随着标准不断演进,现代C++已经形成了自己的编程范式和工程习惯。
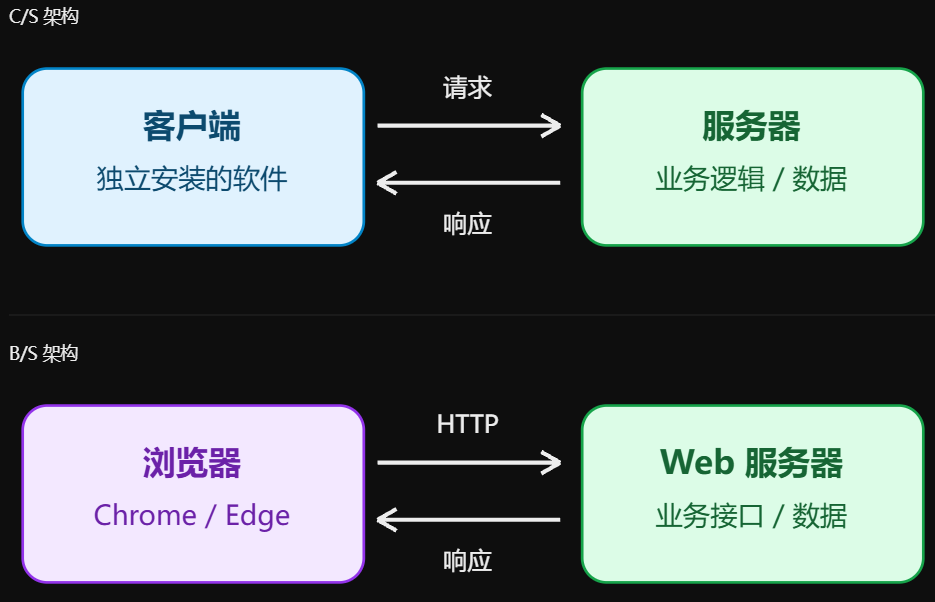
BS 和 CS的区别
二、C++关键字
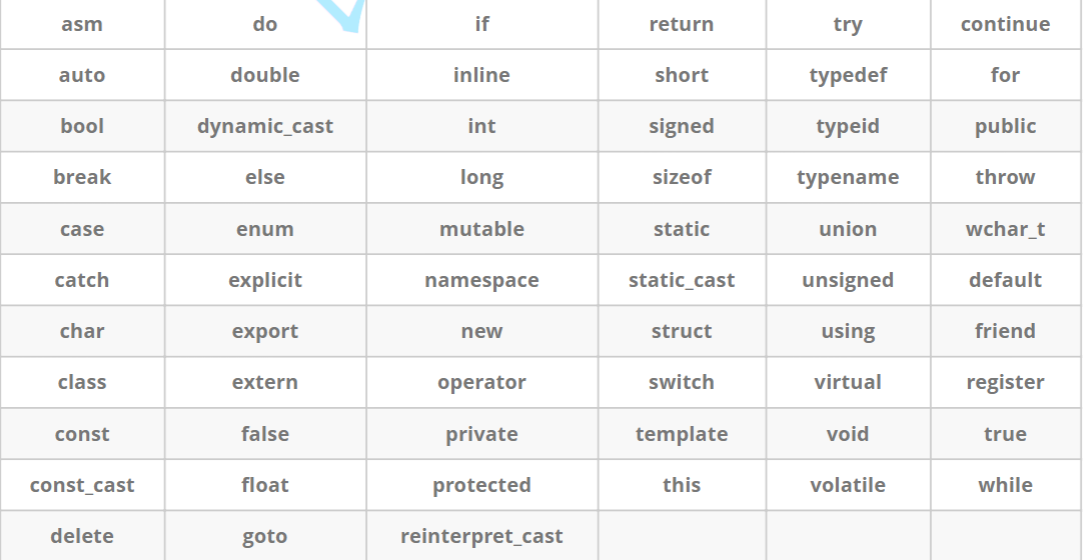
关键词总结。
2.1 什么是关键字
关键字是被语言标准赋予特殊含义的单词,不能再用作普通变量名、函数名或类名。
例如:
1 | int value = 10; |
2.2 常见关键字分类
基本类型
1 | bool char wchar_t short int long float double void |
流程控制
1 | if else switch case default |
面向对象
1 | class public protected private |
泛型与类型系统
1 | template typename |
异常与资源管理
1 | try catch throw |
作用域与组织
1 | namespace using extern static |
C++11常见新增关键字
1 | alignas alignof constexpr decltype |
关键字数量与所采用的C++标准版本有关,因此不能把“C++固定有多少个关键字”当成永远不变的结论。
三、命名空间
3.1 为什么需要命名空间
命名空间里面可以定义:命名空间,函数,变量,对象。
C++所有东西都是放在std命名空间里面的。
大型项目中可能存在大量变量、函数和类。不同模块如果定义了同名标识符,就可能发生名字冲突。
假设两个模块都定义了print函数:
1 | void print(); |
只看函数名无法体现它们分别属于哪个模块。命名空间可以把标识符放入不同作用域:
1 |
|
输出
1 | network |
使用时通过作用域限定符::区分:
1 | network::print(); |
3.2 命名空间的基本定义
1 | namespace math |
命名空间内部可以定义:
- 变量;
- 函数;
- 类;
- 模板;
- 其他命名空间。
3.3 同名命名空间会被合并
同一作用域内可以多次声明同一个命名空间,编译器会把其中的成员视为属于同一命名空间:
1 | namespace math |
使用方式:
1 | int x = math::add(3, 2); |
这个特性允许一个命名空间的声明分布在多个头文件和源文件中。
3.4 嵌套命名空间
1 | namespace company |
C++17可以使用更紧凑的写法:
1 | namespace company::project |
需要注意,后一种写法不是C++11语法。
3.5 使用命名空间成员的三种方式
方式一:完整限定名称
1 | std::cout << "hello" << '\n'; |
这是最清晰、最安全的方式,尤其适合头文件。
方式二:只引入某个成员
1 | using std::cout; |
它只引入指定名字,冲突范围较小。
方式三:引入整个命名空间
1 | using namespace std; |
这种写法在小型示例中比较方便,但会把大量名字引入当前作用域,可能导致冲突。
3.6 为什么不要在头文件中写using namespace std
头文件会被许多源文件包含。头文件中的using namespace std;会影响所有包含者,造成不可控的名字污染。
推荐做法:
1 | // user.hpp |
在范围较小的函数内部使用using声明通常更容易控制:
1 | void test() |
3.7 全局作用域限定符
当局部变量遮蔽了全局变量时,可以用::访问全局作用域:
1 | int value = 10; |
四、C++输入与输出
4.1 标准输入输出流
C++标准库通过<iostream>提供常用流对象:
| 对象 | 作用 |
|---|---|
std::cin |
标准输入 |
std::cout |
标准输出 |
std::cerr |
标准错误输出,通常立即输出 |
std::clog |
标准日志输出,可缓冲 |
基础示例:
1 |
|
<<称为流插入运算符,>>称为流提取运算符。标准库针对不同类型重载了这些运算符,因此通常不需要像printf和scanf那样手动写%d、%lf等格式说明符。
4.2 连续输入输出
1 | int number = 0; |
表达式从左向右依次把数据送入或取出流。
4.3 std::endl与'\n'的区别
两者都会换行,但std::endl还会刷新输出缓冲区:
1 | std::cout << "hello" << std::endl; // 换行并刷新 |
普通文本输出优先使用'\n'。只有确实需要立刻刷新数据时,再使用std::endl。
4.4 检查输入是否成功
用户可能输入非法内容,所以工程代码应检查流状态:
1 |
|
4.5 operator>>读取字符串的限制
1 | std::string name; |
该操作遇到空白字符就会停止。如果要读取包含空格的一整行,应使用std::getline:
1 |
|
如果前面刚使用过operator>>,输入缓冲区中可能残留换行符。可以先用std::ws跳过前导空白:
1 | std::getline(std::cin >> std::ws, line); |
五、缺省参数
5.1 基本概念
缺省参数也称默认参数。声明函数时可以为形参指定默认值;调用者没有传入对应实参时,编译器会使用默认值。
1 |
|
5.2 全缺省参数
1 | void show(int a = 10, int b = 20, int c = 30); |
5.3 半缺省参数
默认参数必须从右向左连续给出:
1 | void connect(const char* host, |
下面的声明是错误的:
1 | void connect(const char* host = "127.0.0.1", |
调用时只能省略末尾参数,不能跳过中间参数。
5.4 默认参数通常写在声明中
推荐把默认参数写在头文件的函数声明中,定义处不再重复:
1 | // log.hpp |
1 | // log.cpp |
同一作用域中,已经给出的默认参数不能再次定义,即使两次给出的值相同也不行。
5.5 默认实参在调用点生效
默认参数主要是编译期语法机制。编译器在调用点根据当前可见声明补上缺少的实参。
这意味着修改库函数的默认值后,依赖它的调用代码通常也需要重新编译。
5.6 默认值不一定是编译期常量
“默认值必须是常量”并不准确。默认实参可以是满足语法和作用域要求的表达式,并在每次调用时求值:
1 |
|
不过,默认实参不能随意依赖声明位置中不可用的局部自动变量。工程中更推荐使用简单、稳定、容易理解的默认值。
5.7 默认参数与函数重载的歧义
1 | void test(int value); |
调用:
1 | test(1); |
两个候选函数都能匹配,因此会产生二义性。设计接口时应避免默认参数和重载形成竞争。
六、函数重载
6.1 什么是函数重载
在同一作用域中,可以定义多个同名函数,只要它们的参数列表不同:参数类型,参数个数, 参数类型+参数个数。
1 | int add(int left, int right) |
调用时,编译器根据实参类型选择合适的函数:
1 | add(1, 2); // int版本 |
6.2 哪些差异可以构成重载
参数个数不同
1 | void print(int value); |
参数类型不同
1 | void print(int value); |
参数类型顺序不同
1 | void print(int value, char ch); |
引用的const属性不同
1 | void process(int& value); |
对于可修改左值,int&版本更匹配;对于常量或临时对象,只能选择const int&版本。
6.3 仅返回值不同不能构成重载
1 | int calculate(int value); |
这两个声明的参数列表完全相同,不能构成重载。因为调用者可以忽略返回值:
1 | calculate(10); |
此时编译器无法根据上下文决定应该调用哪个函数。
6.4 顶层const不能区分值参数
1 | void func(int value); |
二者不是不同的重载。按值传参本来就会创建形参副本,形参内部能否修改副本不影响调用接口。
但是,指针指向对象的const属于底层const,可以区分重载:
1 | void func(int* ptr); |
6.5 重载决议的基本顺序
编译器会为候选函数比较转换成本,常见优先级可以粗略理解为:
- 精确匹配;
- 类型提升;
- 标准类型转换;
- 用户自定义转换;
- 可变参数匹配。
示例:
1 | void show(int value); |
如果不存在唯一的最佳匹配,调用就会产生二义性。
1 | void test(long value); |
6.6 函数重载与名字修饰
C++编译器通常会把函数名、命名空间、类名、参数类型等信息编码进链接符号,这个过程称为名字修饰,也叫name mangling。
例如:
1 | int add(int, int); |
源代码中都叫add,但编译后的符号通常不同,因此链接器能够区分两个函数。
名字修饰规则属于ABI的一部分,不同编译器、平台和ABI可能采用不同格式,不应该依赖某个示例中的具体符号字符串编写业务逻辑。
6.7 C语言为什么不支持函数重载
C语言本身没有函数重载规则,其常见ABI也不会像C++那样利用参数类型形成多个重载符号。因此,同一作用域不能存在多个同名C函数。
更准确地说,这是语言规则和链接约定共同形成的结果,而不只是“C编译器没有修改函数名”。
6.8 extern "C"
C++调用C接口时,可以使用C语言链接:
1 | extern "C" int c_add(int left, int right); |
常见头文件写法:
1 |
|
这样,该头文件既可以被C编译器包含,也可以被C++编译器包含。
需要注意:
extern "C"指定的是语言链接方式;- 它不会把C++函数体“变成C语言代码”;
- C语言链接下不能依赖C++函数重载导出多个同名接口;
- 跨语言接口通常还要考虑数据布局、异常、内存所有权和调用约定。
七、引用
7.1 引用的基本概念
引用是已有对象的别名:
1 | int value = 10; |
ref与value表示同一个对象。对ref的修改就是对value的修改。
7.2 引用的三个基本特性
定义时必须初始化
1 | int& ref; // 错误 |
一个对象可以有多个引用
1 | int value = 10; |
引用初始化后不能改绑
1 | int a = 10; |
最后一句不是让ref改为引用b,而是把b的值赋给a。
7.3 引用的语义与实现
在C++语言语义中,引用是别名,不是可独立操作的指针。编译器在很多场景下可能使用地址实现引用,但这是实现细节。
因此不能简单地断言“引用一定占一个指针大小的内存”。例如局部引用经过优化后可能完全不占独立存储,而类中的引用成员通常需要实现层面的存储支持。
7.4 常引用
常量左值引用不能通过该引用修改对象:
1 | int value = 10; |
常引用可以绑定常量和临时对象:
1 | const int& a = 10; |
临时对象的生命周期会延长到该局部引用的生命周期结束。
7.5 类型转换与常引用
1 | double number = 12.34; |
这里ref并不是直接引用number。编译器先把number转换为临时int对象,再让ref绑定该临时对象。因此:
1 | number = 99.9; |
这是初学引用时容易忽略的细节。
7.6 引用作为函数参数
引用参数可以直接修改实参:
1 | void swapValue(int& left, int& right) |
调用:
1 | int a = 10; |
如果函数只读取对象,推荐使用常引用:
1 |
|
这样既避免复制,也明确表示函数不会通过该参数修改对象。
7.7 小型类型不必盲目传常引用
对于int、char、double和普通指针等小型类型,按值传递往往更简单,性能也可能更好:
1 | int square(int value) |
是否传引用应该结合以下因素判断:
- 是否需要修改实参;
- 对象复制成本;
- 对象大小;
- 所有权和生命周期;
- 接口语义是否清晰。
7.8 引用作为返回值
返回引用可以让调用者直接访问原对象:
1 | int& counter() |
返回引用的前提是被引用对象在函数返回后仍然存活。
7.9 绝对不能返回局部变量的引用
1 | int& add(int left, int right) |
result在函数结束时被销毁,返回的引用随后悬空。访问悬空引用会产生未定义行为。
可以安全返回引用的典型对象包括:
- 生命周期足够长的全局对象;
- 静态局部对象;
- 由调用者传入且仍存活的对象;
- 生命周期足够长的对象成员;
- 容器中仍然有效的元素。
最后一种情况还要考虑容器操作是否会让引用失效。例如vector扩容可能使已有元素引用失效。
7.10 不要为了性能盲目返回引用
现代C++具有返回值优化、拷贝消除和移动语义。按值返回对象经常非常高效,并且更容易保证生命周期安全:
1 | std::string makeMessage() |
只有当接口确实要暴露某个已有对象时,才应该返回引用。
7.11 引用和指针的区别
| 对比项 | 引用 | 指针 |
|---|---|---|
| 初始化 | 必须初始化 | 可以暂不初始化,但不推荐 |
| 改变绑定/指向 | 不能改绑 | 可以重新指向其他对象 |
| 空值 | 合法程序中应绑定有效对象 | 可以为nullptr |
| 访问对象 | 直接使用引用名 | 需要*或-> |
| 自增含义 | 被引用对象加一 | 指针移动到下一元素 |
| 多级形式 | 没有普通“引用的引用”变量 | 支持多级指针 |
| 典型语义 | 别名、必选对象 | 地址、可选对象或遍历位置 |
选择建议:
- 参数必须关联有效对象时,可优先考虑引用;
- 参数允许“没有对象”时,使用指针并以
nullptr表达空状态; - 涉及动态数组遍历、底层内存和C接口时,经常需要指针。
八、内联函数
8.1 inline的传统动机
普通函数调用可能涉及参数传递、保存现场、跳转和返回。对于函数体非常小且调用频繁的函数,编译器可能把函数体直接放到调用点,以减少调用开销,这称为内联展开。
1 | inline int add(int left, int right) |
8.2 inline不保证发生内联展开
inline只是与内联相关的语言说明符,不是强制优化命令。编译器可以:
- 拒绝展开标有
inline的函数; - 展开没有标
inline的普通函数; - 根据优化级别、函数大小、调用环境等自行决定。
递归、复杂循环、函数过大、无法确定目标等因素可能影响优化,但不存在“只要出现循环就绝对不能内联”的语言规则。
是否真正展开,应查看编译器生成的汇编代码或优化报告。
8.3 现代C++中inline更重要的含义
inline允许一个函数或变量在多个翻译单元中存在相同定义而不违反单一定义规则,前提是这些定义满足标准要求。
因此,内联函数通常直接定义在头文件中:
1 | // math.hpp |
多个.cpp文件包含该头文件时,都能看到完整定义。
8.4 类内定义的成员函数
在类定义内部定义的成员函数通常隐式具有inline语义:
1 | class Counter |
这里的inline语义仍不等于编译器一定展开调用。
8.5 为什么声明和定义通常不能分离到不可见位置
如果每个使用内联函数的翻译单元都需要看到定义,那么只在头文件声明、把定义藏在另一个.cpp文件里,可能导致定义不可见或链接问题。
问题的核心不是“展开后函数一定没有地址”,因为内联函数仍然可以被取地址;核心是内联函数的定义可见性与单一定义规则。
8.6 宏与内联函数
宏函数:
1 |
宏存在一些问题:
- 不进行常规类型检查;
- 调试困难;
- 参数可能被重复求值;
- 容易受到括号和优先级影响;
- 不遵循普通函数的作用域规则。
例如:
1 | MAX_VALUE(i++, j++) |
某个参数可能执行多次自增,产生意外副作用。
更推荐使用函数模板:
1 | template<class T> |
常量宏也可以优先替换为const或constexpr:
1 | constexpr int maxConnections = 1024; |
九、auto类型推导
9.1 auto的作用
C++11中的auto是占位类型说明符。编译器根据初始化表达式推导变量类型:
1 | auto number = 10; // int |
推导发生在编译期,不会给程序增加运行时类型判断开销。
9.2 使用auto必须初始化
1 | auto value; // 错误:没有初始化表达式,无法推导类型 |
9.3 auto默认会丢弃引用和顶层const
1 | const int value = 10; |
a和b都是新的int对象。修改它们不会修改value。
如果需要保留引用:
1 | auto& c = value; // const int& |
9.4 auto与指针
1 | int value = 10; |
两种写法都能推导出指针。显式写auto*有时能更明显地表达“这里应当是指针”。
9.5 auto与const
1 | int value = 10; |
要区分“指针本身是常量”和“指向的对象是常量”:
1 | auto* const fixedPointer = &value; // int* const |
9.6 同一条声明中的变量必须推导一致
1 | auto a = 1, b = 2; // 正确,均为int |
1 | auto c = 3, d = 4.0; // 错误:分别需要int和double |
一条简单声明中的auto必须得到一致的类型。
9.7 C++11中auto不能直接作为普通函数形参
1 | void print(auto value); // 不是合法的C++11普通函数声明 |
C++11中应使用函数模板:
1 | template<class T> |
C++14允许Lambda形参使用auto,C++20才正式支持缩写函数模板形式的普通函数形参。因此判断代码是否合法时必须明确标准版本。
9.8 auto不能直接推导原生数组元素类型声明
下面的写法不能用auto直接得到普通数组声明:
1 | auto values[] = {1, 2, 3}; // 不应这样声明 |
可以让auto接收已有数组的引用:
1 | int values[] = {1, 2, 3}; |
或者在现代代码中使用标准容器。
9.9 auto的适用场景
类型很长
1 | std::map<std::string, std::vector<int>>::iterator it = data.begin(); |
可以简化为:
1 | auto it = data.begin(); |
类型由表达式自然决定
1 | auto result = calculate(); |
配合范围for和Lambda
1 | for (const auto& element : container) |
9.10 不要滥用auto
如果类型信息对阅读代码很重要,或者隐式转换可能令人误解,明确写出类型往往更清晰:
1 | auto count = getValue(); |
如果不了解getValue(),读者无法立即知道count是整数、浮点数还是某种代理类型。
使用原则是:减少无意义重复,同时保留重要语义。
十、基于范围的for循环
10.1 基本语法
1 | int values[] = {1, 2, 3, 4, 5}; |
范围for适合遍历数组和支持begin、end访问的对象。
10.2 值遍历不会修改原元素
1 | int values[] = {1, 2, 3}; |
value是每个元素的副本,原数组仍然是1, 2, 3。
10.3 引用遍历可以修改原元素
1 | for (auto& value : values) |
现在原数组变成2, 4, 6。
10.4 只读遍历优先使用const auto&
1 | std::vector<std::string> names = {"Alice", "Bob", "Carol"}; |
这样可以避免复制字符串,又防止循环体意外修改元素。
10.5 范围必须可以确定
原生数组在当前作用域中保留长度信息,因此可以使用范围for:
1 | void localExample() |
但数组作为普通函数参数时会退化为指针:
1 | void printArray(int values[]) |
可以使用数组引用模板保留长度:
1 |
|
10.6 范围for的大致展开形式
理解其底层逻辑有助于学习迭代器。下面只是概念化的等价形式:
1 | for (auto beginIt = container.begin(), endIt = container.end(); |
实际标准展开规则还涉及数组、成员begin/end和参数依赖查找,不能把上面的示意代码当成所有情况的逐字翻译。
10.7 循环中修改容器要谨慎
如果在遍历过程中执行会导致迭代器失效的操作,范围for也可能出错:
1 | for (const auto& value : values) |
是否允许边遍历边修改,要根据具体容器和具体操作的迭代器失效规则判断。
十一、nullptr
11.1 NULL的问题
传统C++代码经常使用0或NULL表示空指针:
1 | int* p1 = 0; |
但在许多C++实现中,NULL本质上是值为零的整型宏。这会影响函数重载:
1 | void func(int value) |
程序员想表达空指针,编译器看到的却可能是整数。
11.2 nullptr是专用空指针字面量
C++11引入nullptr:
1 | int* pointer = nullptr; |
它的类型是std::nullptr_t,可以转换为任意对象指针或成员指针类型,但不会像整数0那样优先匹配普通整数重载。
1 | func(nullptr); // 调用func(int*) |
11.3 nullptr不需要额外定义
nullptr是语言关键字,不是宏,也不需要某个头文件才能写出来。
如果需要显式使用类型名std::nullptr_t,应包含<cstddef>:
1 |
|
11.4 多个指针重载仍可能产生二义性
1 | void process(int* pointer); |
nullptr解决的是“整数零和空指针含义混淆”,并不能自动消除所有重载歧义。
可以显式转换目标类型:
1 | process(static_cast<int*>(nullptr)); |
11.5 实际编码建议
在C++11及以后版本中:
- 使用
nullptr表示空指针; - 不使用
0表达空指针; - 新代码中尽量不使用
NULL; - 解引用前确认指针是否有效;
- 能用RAII对象或智能指针管理资源时,不裸露所有权。
十二、综合示例
下面的程序把命名空间、默认参数、函数重载、引用、inline、auto、范围for和nullptr组合起来。
1 |
|
预期输出:
1 | Alice: 63 |
12.1 代码中的知识点
namespace demo隔离业务类型和函数;passed和addBonus使用默认参数;- 两个
print通过参数类型形成重载; const Student&避免复制并保证只读;Student&允许函数修改原对象;inline使头文件式小函数可以拥有多翻译单元定义;auto&遍历并修改学生;const auto&只读遍历且避免复制;nullptr明确表达空指针;- 显式转换用于消除两个
print重载之间潜在的理解歧义。
十三、常见错误总结
13.1 在头文件中引入整个std命名空间
问题:污染所有包含该头文件的源文件。
修正:在头文件中使用std::string、std::vector等完整名称。
13.2 默认参数从左侧开始设置
问题:调用者无法跳过左侧参数再指定右侧参数。
修正:默认参数必须位于参数列表尾部并保持连续。
13.3 声明和定义重复给默认参数
问题:同一作用域不能重复定义同一个默认实参。
修正:通常只在头文件声明中给出默认参数。
13.4 认为返回值不同可以重载
问题:忽略返回值的调用无法决定选择哪个函数。
修正:重载必须在参数列表或成员函数限定条件等可用于重载决议的信息上存在差异。
13.5 返回局部变量的引用
问题:函数结束后局部对象销毁,引用悬空。
修正:按值返回,或者只返回生命周期确实足够长的对象引用。
13.6 把引用简单理解为常量指针
问题:二者在语法和语言语义上并不相同。
修正:把引用理解为别名,把指针理解为可以保存和操作的地址值。
13.7 认为inline一定展开
问题:最终是否展开由编译器优化决定。
修正:把inline同时理解为与单一定义规则和链接语义有关的说明符。
13.8 使用auto时意外发生复制
1 | for (auto element : container) |
修正:需要修改原对象时用auto&,只读且避免复制时用const auto&。
13.9 使用NULL调用重载函数
问题:NULL可能表现为整数常量,选择错误重载。
修正:C++11以后使用nullptr。
13.10 认为nullptr能解决所有指针重载歧义
问题:多个不同指针类型的候选函数可能同样匹配nullptr。
修正:改进接口设计,或者显式转换为空的目标指针类型。
十四、面试常见问题
14.1 命名空间解决什么问题
命名空间创建独立作用域,用于组织代码、隔离标识符并减少大型项目中的名字冲突。
14.2 为什么不建议在头文件中写using namespace std
因为它会影响每个包含该头文件的翻译单元,扩大名字污染范围,并可能让后续代码出现重载歧义或名称冲突。
14.3 默认参数是在编译期还是运行期处理
缺少哪个实参主要由编译器在调用点根据可见声明确定;默认表达式本身可能在运行时求值。
14.4 函数重载的条件是什么
同一作用域中的同名函数需要具有可区分的参数列表,例如参数个数、类型或顺序不同。仅返回类型不同不能构成重载。
14.5 C++重载的底层基础是什么
编译器先在语义分析阶段完成重载决议,再通过名字修饰等ABI机制产生可供链接器区分的符号。
14.6 extern "C"有什么用
它为声明指定C语言链接,常用于C与C++之间的接口兼容。它并不把C++函数体转换成C语言,也不能让C接口直接支持C++重载。
14.7 引用能否不初始化
普通引用必须在定义时绑定对象。合法程序不应构造所谓的“空引用”。如果接口需要表示“可能不存在”,通常应使用指针、智能指针或其他显式可空类型。
14.8 引用和指针最核心的语义差异是什么
引用表达已有对象的别名关系,并且不能改绑;指针是保存地址的对象,可以为空,也可以重新指向其他对象。
14.9 什么时候可以返回引用
只有当被引用对象在函数返回后仍然有效,并且接口确实需要暴露该对象时才返回引用。绝不能返回普通局部变量的引用。
14.10 inline的作用是什么
它最初用于建议编译器进行内联优化,但是否展开由编译器决定。在现代C++中,它还具有重要的单一定义规则语义,使符合条件的相同定义可以出现在多个翻译单元。
14.11 auto是否属于动态类型
不是。auto在编译期完成静态类型推导,变量最终仍有确定的静态类型,不会因此增加运行时类型判断。
14.12 auto、auto&和const auto&有什么区别
auto通常得到一个新值,常会移除引用和顶层const;auto&绑定原对象,可以保留引用并根据对象属性保留const;const auto&只读绑定,可以避免复制,也能绑定临时对象。
14.13 范围for为什么不能直接遍历数组形参
原生数组传入普通函数后会退化为指针,长度信息丢失。范围for无法从一个裸指针确定起点和终点。
14.14 nullptr为什么比NULL安全
nullptr拥有专门的std::nullptr_t类型,明确表达空指针语义,在重载决议中不会被当成普通整数零。
十五、学习路线建议
掌握本章后,可以按以下顺序继续学习:
- 类和对象、构造函数、析构函数;
const成员函数与this指针;- 拷贝构造和赋值运算符;
- 内存管理与RAII;
- 继承和多态;
- 模板与泛型编程;
- STL容器、迭代器和算法;
- C++11移动语义、Lambda、智能指针和线程库。
学习每个语法时都可以追问四个问题:
- 它解决了什么问题?
- 它在编译期还是运行期生效?
- 对象的生命周期和所有权是什么?
- 哪些错误会导致编译失败,哪些会导致未定义行为?
十六、总结
本章的核心不是孤立地背诵语法,而是建立几组关键联系:
- 命名空间通过作用域解决名字冲突;
- 输入输出流通过运算符重载统一处理不同类型;
- 默认参数减少重复实参,但需要控制声明位置和重载歧义;
- 函数重载依赖参数差异、重载决议和ABI名字修饰;
- 引用表达别名关系,使用时必须始终关注对象生命周期;
inline是否展开由编译器决定,其现代意义还包括ODR规则;auto进行编译期类型推导,不是动态类型;- 范围
for让遍历更简洁,但值、引用和常引用语义不同; nullptr用专门类型表达空指针,避免NULL与整数重载混淆。
这些知识既是C++语法入门,也是后续理解类、模板、STL、移动语义和现代资源管理的基础。
